Giờ AI viết code thay tôi — nên tôi tạo một công cụ để ngăn nó phá hỏng hệ thống i18n
AI hiện đang đảm nhận phần lớn việc viết code cho tôi — nhưng nó cũng âm thầm làm hỏng các translation keys: hardcode string, tạo ra orphan keys, và hallucinate namespace. Đây là lý do tôi xây dựng i18n-sharpen, một i18n linter dựa trên AST, và định nghĩa thực sự của một 'AI-friendly codebase'.
Tôi gần như không còn tự gõ code bằng tay nữa. Một thời gian trở lại đây, các AI agent đã đảm nhận phần lớn việc gõ code trong các dự án của tôi — tôi mô tả những gì mình muốn, review diff, rồi ship. Tốc độ rất nhanh, chất lượng thực sự tốt, và đôi khi nó mang lại cảm giác như tôi đang “ăn gian” vậy.
Cho đến một ngày, tôi mở thư mục locales/ của một ứng dụng đa ngôn ngữ và nhận ra nó đã trở thành một mớ hỗn độn. Những keys không trỏ đi đâu cả. Những string tiếng Anh nằm lẫn trong file tiếng Việt. Những placeholder được dịch dang dở. Một hàm t("...") gọi đến một key hoàn toàn không còn tồn tại.
Không hẳn là lỗi của AI. Khi review độc lập, mỗi thay đổi đều trông rất hợp lý. Nhưng code review thường được thực hiện trên từng PR riêng lẻ, trong khi sự suy thoái của hệ thống dịch thuật (translation rot) lại xảy ra trên tất cả các PR cùng lúc. Đến khi bạn nhận ra vấn đề, bạn không đơn thuần là đang fix bug nữa — bạn đang phải “khảo cổ” lại toàn bộ codebase.
Đó chính là lý do tôi xây dựng i18n-sharpen [1]. Tuy nhiên, sâu xa hơn, nó xuất phát từ một quan điểm mà tôi ngày càng tin tưởng: khi AI đảm nhận phần lớn việc viết code, codebase của bạn cần những guardrails tự động mà máy tính có thể kiểm tra — chứ không chỉ là những conventions chờ đợi con người tự ghi nhớ. i18n chỉ là ví dụ đầu tiên khiến tôi không thể phớt lờ quan điểm đó.
Kiểu lỗi mới: Cách AI âm thầm phá hỏng i18n
Nếu bạn đang xây dựng các ứng dụng đa ngôn ngữ với sự hỗ trợ của AI agent, rất có thể bạn đã gặp cả năm trường hợp dưới đây, dù có thể bạn chưa từng để ý gọi tên chúng:
- Nó hardcode các string. Bạn yêu cầu tạo một button, kết quả nhận được là
placeholder="Submit"thay vìplaceholder={t("form.submit")}. Code vẫn render bình thường. Vẫn được ship lên production. Nhưng nó không thể được dịch. - Nó quên khai báo key. Code có gọi
t("checkout.confirm"), nhưng không ai thêmcheckout.confirmvào file locale. Ở môi trường dev, ứng dụng fallback hiển thị luôn tên key nên không ai phát hiện ra. - Nó chỉ thêm key cho một ngôn ngữ. File tiếng Anh được cập nhật key mới, nhưng tiếng Nhật và tiếng Việt thì không. Các file locale của bạn bắt đầu lệch pha nhau một cách âm thầm.
- Nó để lại những dead keys. Nó xóa đi một component UI nhưng không xóa các translations liên quan. Những string này nằm lại vĩnh viễn, bởi vì việc xóa đi mang lại cảm giác rủi ro và không ai dám chắc chúng còn được sử dụng hay không.
- Nó nhớ nhầm vị trí của các keys. Đây là vấn đề khiến tôi đau đầu nhất. Việc phân chia namespace cho locale làm mọi thứ phức tạp hơn: một component vốn nằm ở nhánh này của cấu trúc locale, sau vài lần refactor đã được chuyển sang nhánh khác. Nhưng ở một lần sửa đổi sau đó, AI lại đọc theo cấu trúc cũ, thêm lại các keys vào namespace cũ, hoặc đơn giản là “hallucinate” ra một namespace chưa từng tồn tại rồi trỏ
t()vào đó. Kết quả là cùng một string bị định nghĩa ở hai nơi, và một nửa số hàm gọi đang trỏ vào những keys “bóng ma”.
Điều khiến đây trở thành một loại vấn đề mới là: các AI agent code rất nhanh và xử lý chính xác trong phạm vi cục bộ. Mỗi file diff đều nhỏ và hợp lý. Thói quen manual review của chúng ta được thiết kế để bắt lỗi ngay trước mắt — chứ không phải sự trôi dạt tổng hợp sau năm mươi lần merge. Loại lỗi này không gây ồn ào. Nó là entropy tăng dần theo thời gian.
Sự tích tụ tech debt sau hàng ngàn lần chỉnh sửa
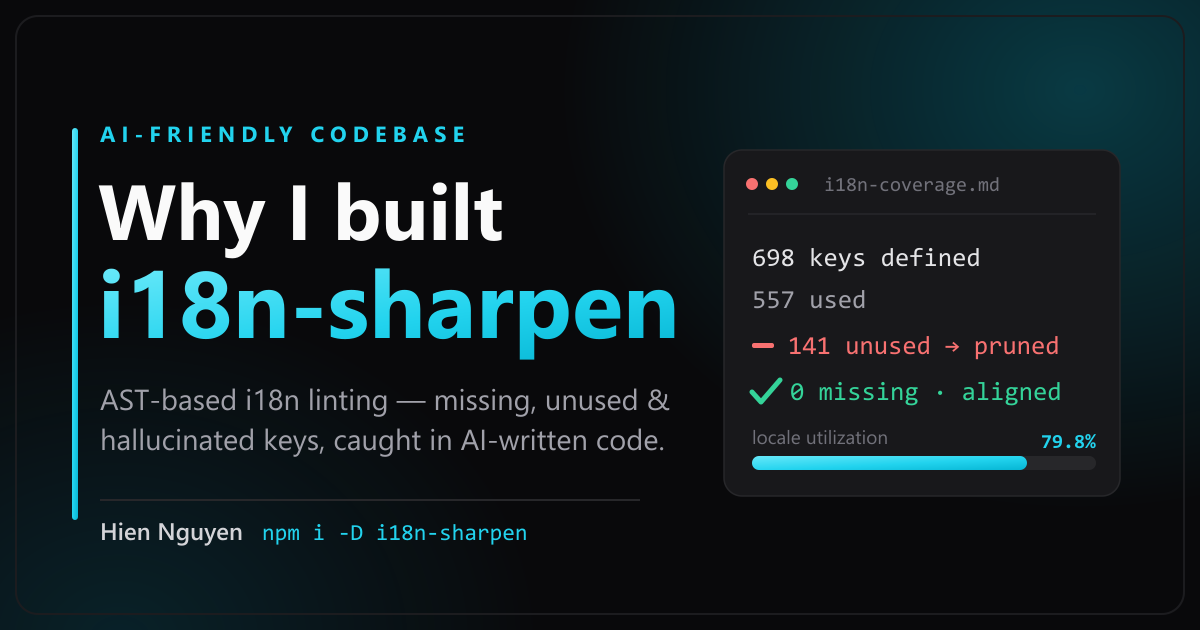
Sau vài tháng để entropy tích tụ, những con số bắt đầu trở nên báo động. Đây là dữ liệu từ một báo cáo coverage thực tế mà i18n-sharpen xuất ra trên dự án của chính tôi [1]:
- 698 translation keys được định nghĩa
- 557 keys thực sự được sử dụng trong source
- 141 unused keys — khoảng 20% là rác
- Tỷ lệ tận dụng locale: 79.8%
Cứ năm key thì có một key thừa. Không phải do ai đó bất cẩn, mà bởi vì mỗi lần refactor có sự can thiệp của AI, hệ thống luôn bị thêm thắt một chút nhưng hiếm khi được dọn dẹp đi — và một phần trong số “unused keys” đó đơn giản chỉ là cùng một string bị duplicate sai namespace khi component di chuyển. Nhân con số đó với sự lệch pha giữa các locale và các untranslated placeholders, hệ thống dịch thuật không còn là “source of truth” nữa, mà trở thành một gánh nặng (liability) bạn phải đẩy xuống cho người dùng trong mỗi bundle.
Điều gây bực bội là đây chính xác là loại vấn đề máy tính có thể bắt được. Nó có tính cơ học. Hoàn toàn có thể đếm được. Vậy tại sao tôi lại phải đi dò tìm thủ công?
Vì sao grep và JSON-diff không đủ giải quyết vấn đề
Phản xạ đầu tiên của tôi — và cũng là phiên bản đầu tiên của công cụ này (khi đó mang tên i18n-cop) — là một cách tiếp cận rõ ràng: dùng regex quét code để tìm t("..."), diff kết quả đó với các file JSON, và xong.
Nhưng nó chưa đủ, và tôi đã mất một lúc để chấp nhận lý do tại sao. grep chỉ pattern-match các chuỗi ký tự (string literals). Nó không hiểu code. [1] Chỉ cần keys của bạn có tính dynamic một chút, các text scanner sẽ lập tức bị “mù”:
t(`auth.${action}`)        // grep chỉ nhìn thấy dấu backtick, không thấy key
t(benefit.key)             // fully dynamic — vô hình với grep
<Trans i18nKey="modal.title" />   // framework attribute, không phải là hàm t()
Các ứng dụng thực tế chứa đầy những cấu trúc như thế này: template-literal keys, JSX spreads, hay các attributes của Vue/Svelte/Astro mang các translation keys dưới cú pháp riêng của từng framework. Một regex hoặc sẽ bỏ sót chúng (báo false positive là “unused”), hoặc flag nhầm những keys hợp lệ thành “missing”. Cả hai trường hợp đều khiến bạn không còn tin tưởng vào công cụ nữa, và một linter mà bạn không tin tưởng thì thà không có linter còn hơn.
Đó là lý do i18n-cop phát triển thành i18n-sharpen, và engine regex được thay thế bằng các AST parsers thực thụ cho từng framework [1]. Thay vì đối sánh văn bản, nó parse TS, JS, Vue, Svelte, và Astro theo cách mà một compiler hoạt động. Tagline tôi tâm đắc nhất đã tóm tắt rõ điều này: giữ cho file locale sạch sẽ “với độ chính xác của một compiler, chứ không phải của một grep.” [1]
Nền tảng AST chính là chìa khóa mở ra những khả năng mà một JSON-diff thông thường không bao giờ làm được [1]:
- Thực sự thấu hiểu dynamic keys. Nó detect và phân loại chúng — ví dụ
t(`auth.${action}`)được hiểu là nối chuỗi có cấu trúc, cònt(benefit.key)là fully dynamic — thay vì lẳng lặng đếm nhầm chúng thành unused keys. - Phát hiện hardcoded strings (
--check-hardcoded). Nó flag các untranslated text nằm trong các attributes JSX/Vue/Astro (nhưplaceholder="Submit") — lỗi rất đặc trưng khi dùng AI agent — và tự động fail CI khi phát hiện. - Phát hiện untranslated placeholders. Nó bắt những keys có value vẫn trùng khớp hoàn toàn với đường dẫn dot-path của chính nó (tức là chỉ mới copy vào locale file nhưng chưa hề được dịch).
- Thiết kế lightweight. Công cụ thực hiện toàn bộ những việc trên xuyên suốt tech stack nhưng kích thước chỉ khoảng ~720 kB, áp dụng lazy-load để chỉ tải đúng compiler mà dự án sử dụng — giúp chi phí tích hợp vào bất cứ dự án nào đều ở mức tối thiểu.
Định nghĩa “AI-friendly codebase” đối với tôi
Đây mới là phần tôi thực sự quan tâm, vĩ mô hơn câu chuyện của i18n rất nhiều.
Khi AI đảm nhận viết phần lớn code, bottleneck đã dịch chuyển. Nó không còn là việc gõ code nữa — các agent giờ đây làm điều đó chỉ trong vài giây. Bottleneck mới chính là làm sao ngăn codebase âm thầm bị code rot dưới tốc độ phát triển đó. Bạn không thể giải quyết bài toán này chỉ bằng văn hóa code review hay một trang wiki liệt kê các conventions. Bởi vì AI model không đọc wiki của bạn, và reviewer không thể thấy được những sự lệch pha nhỏ tích tụ theo thời gian.
Điều hiệu quả nhất là biến tính đúng đắn (correctness) thành các quy tắc có thể thực thi tự động (executable). Vì thế, i18n-sharpen không phải là một công cụ riêng lẻ — nó là một quy tắc trong một hệ thống mà tôi đã xây dựng dần quanh các AI agent của mình. Tổng thể hệ thống đó bao gồm:
- Các conventions bắt buộc AI tuân thủ, được ghim chặt vào rules của Claude Code: clean code, DRY, KISS, SOLID; phân định rõ ràng các file
types,constants, vàutilsthay vì khai báo inline bừa bãi; và một ranh giới cứng “không mix nhiều concerns trong một file” để ngăn agent code lan man. - Các Automated gates chạy lúc pre-commit và trên CI: Prettier và ESLint kiểm soát style và correctness, một hệ thống AI code review hoạt động như chốt chặn thứ hai,
jscpdbắt các đoạn code trùng lặp do copy-paste, và test suite để bắt các lỗi behavior regression.
Yếu tố giúp danh sách quy tắc trên thực sự hoạt động — thay vì nằm mốc meo trong một file style guide — chính là Claude Code hooks. Chúng tự động hóa các nguyên tắc: một hook chạy đồng thời với các actions của agent — format, lint, và chạy check ngay khi file thay đổi — cộng thêm một pre-commit hook hoạt động như chốt chặn trước khi commit, và CI đóng vai trò là chốt chặn cuối cùng. Việc kiểm soát chất lượng không còn là trách nhiệm ai đó phải nhớ; nó được đấu nối trực tiếp vào dev loop. Agent không thể lén lút bypass linter, và tôi cũng vậy.
Hãy chú ý điểm chung của tất cả các công cụ trên: với mỗi vấn đề, cộng đồng đã cung cấp sẵn những công cụ trưởng thành (mature tools). ESLint, Prettier, jscpd, test runner, pre-commit hook — tất cả đều đã được giải quyết và sẵn sàng sử dụng. i18n chính là ngoại lệ. Trước đó, tôi không tìm thấy bất kỳ công cụ nào phân tích i18n ở cấp độ AST — xử lý missing keys, unused keys, dynamic patterns, hardcoded strings — xuyên suốt trên TS, JS, Vue, Svelte và Astro. Mọi khoảng trống khác trong thiết lập “AI-friendly” của tôi đều đã có câu trả lời. Riêng phần này thì chưa. Khoảng trống đó là một nửa nguyên nhân khiến i18n-sharpen ra đời.
Kết quả là nó trở thành guardrail cho i18n trong toàn bộ hệ thống của tôi [1]:
validate— fail build nếu thiếu key, các locale lệch pha, hoặc phát hiện placeholder chưa được dịch. Trả về đúng exit codes của CI (0là clean,1là fail), kèm theo một file báo cáo coverage markdown để comment trực tiếp vào PR.extract— khi agent thực sự code thêmt("new.key"), công cụ tự động quét và sync key đó vào mọi file locale, giúp con người thoát khỏi gánh nặng phải ghi nhớ việc “nhớ thêm key vào mọi nơi”.prune— tìm các dead keys và xóa chúng an toàn (chế độ dry-run mặc định; interactive nếu bạn muốn review từng key).
Khi đưa toàn bộ hệ thống này vào workflow ở local lẫn CI, cục diện sẽ thay đổi hoàn toàn. AI có thể code với tốc độ rất nhanh — và ngay khoảnh khắc nó vô tình hardcode một string hoặc bỏ lại một orphan key, các local hook hoặc CI pipeline sẽ ngay lập tức fail và báo lỗi, trước khi sự xuống cấp (code rot) kịp tích lũy. Các guardrails sẽ thực hiện việc bắt lỗi để cả con người lẫn model AI đều có thể yên tâm bỏ qua gánh nặng này.
Có một khía cạnh tinh tế hơn mà tôi đã đánh giá thấp trong thời gian quá dài: bản thân một codebase rõ ràng, gọn gàng đã là một codebase AI-friendly. Từng convention — từ việc tách biệt types và utils, nguyên tắc một concern cho một file, đến việc naming và thiết lập namespace dễ dự đoán — giờ đây không đơn thuần giúp cho humans dễ đọc nữa. Nó chính là chất lượng đầu vào của model. Cấu trúc càng rõ ràng và đồng nhất, AI đọc context càng chính xác, và số lỗi nó mắc phải ngay từ bước đầu tiên càng ít — bao gồm cả chính vấn đề namespace hallucination kể trên. Đây là một con dao hai lưỡi: một codebase rối rắm buộc AI phải đưa ra các dự đoán, và các dự đoán đó tiếp tục làm cho codebase trở nên lộn xộn hơn; ngược lại, sự gọn gàng (clean) cũng mang lại hiệu ứng cộng dồn theo chiều hướng tích cực. Vì vậy, các guardrails không chỉ đóng vai trò phòng ngự sau khi xảy ra lỗi — chúng định hình code về đúng cấu trúc mà AI có thể làm việc tốt nhất, điều kiện đó giữ cho code luôn clean, và codebase clean lại giúp AI hoạt động hiệu quả hơn. Vòng lặp đó, đối với tôi, chính là định nghĩa thực sự của “AI-friendly”.
Đó là toàn bộ bức tranh. Giải pháp không phải là “ngừng sử dụng AI agent.” Ngược lại: hãy xây dựng những đường ray thật vững chắc để chúng có thể chạy hết công suất.
Tóm lại, hãy thiết lập các guardrails
Mục tiêu ban đầu của tôi không phải là viết một i18n linter. Tôi chỉ muốn giữ cho các dự án của riêng mình không bị ngập trong tech debt, và i18n vô tình là một góc duy nhất của codebase chưa có công cụ kiểm soát tự động. Nhưng tôi tin rằng bài học này mang tính khái quát: khi phần lớn code của chúng ta được viết ra bởi các AI agent, yếu tố tạo đòn bẩy lớn nhất không phải là code thêm nhiều feature — mà là thiết lập những hệ thống tự động để kiểm soát sự minh bạch của một codebase đang thay đổi quá nhanh, đồng thời tự build một công cụ để lấp đầy những khoảng trống mà stack hiện tại của bạn chưa hỗ trợ.
Nếu bạn đang phát triển các ứng dụng đa ngôn ngữ với sự hỗ trợ của AI, hãy thử lệnh này trên dự án của bạn và xem kết quả:
npx i18n-sharpen validateTôi tin chắc dự án của bạn cũng đang chứa hơn 20% dead keys. Kho lưu trữ của dự án đang public trên GitHub [1] — hoan nghênh mọi người star và đóng góp. Tôi cũng rất muốn nghe phiên bản “AI-friendly codebase” của riêng bạn trông như thế nào.
Tài liệu tham khảo
- [1] i18n-sharpen — kho GitHub và package npm (dự án của tác giả). Danh sách tính năng (bộ phân tích AST,
validate/extract/prune,--check-hardcoded, phát hiện active-placeholder & dynamic-key, thiết kế optional-peer-dependency ~720 kB), bảng so sánh grep-vs-AST, ví dụ báo cáo coverage (698 keys / 141 unused / 79.8% utilization), và câu chuyện rewrite enginei18n-cop→i18n-sharpenđều được lấy từ README của dự án. https://github.com/Schalkez/i18n-sharpen · https://www.npmjs.com/package/i18n-sharpen