Sự thật về cách Code chạy: Từ Bare Metal, Hệ điều hành đến Máy ảo
Một góc nhìn toàn cảnh về cách phần mềm thực sự tương tác với phần cứng: từ dòng điện trong môi trường Bare Metal, qua System Calls của Hệ điều hành, đến Bytecode trên Máy ảo.
Khi bạn viết code C++ cho vi điều khiển, bạn không viết phần mềm. Bạn đang định nghĩa một bản thiết kế để thao tác với dòng điện. Khoảng cách từ mã nguồn đến phần cứng vật lý gần như bằng không.
Bật/tắt công tắc vật lý (Bare Metal)
Trình biên dịch chuyển đổi Text thành Điện áp
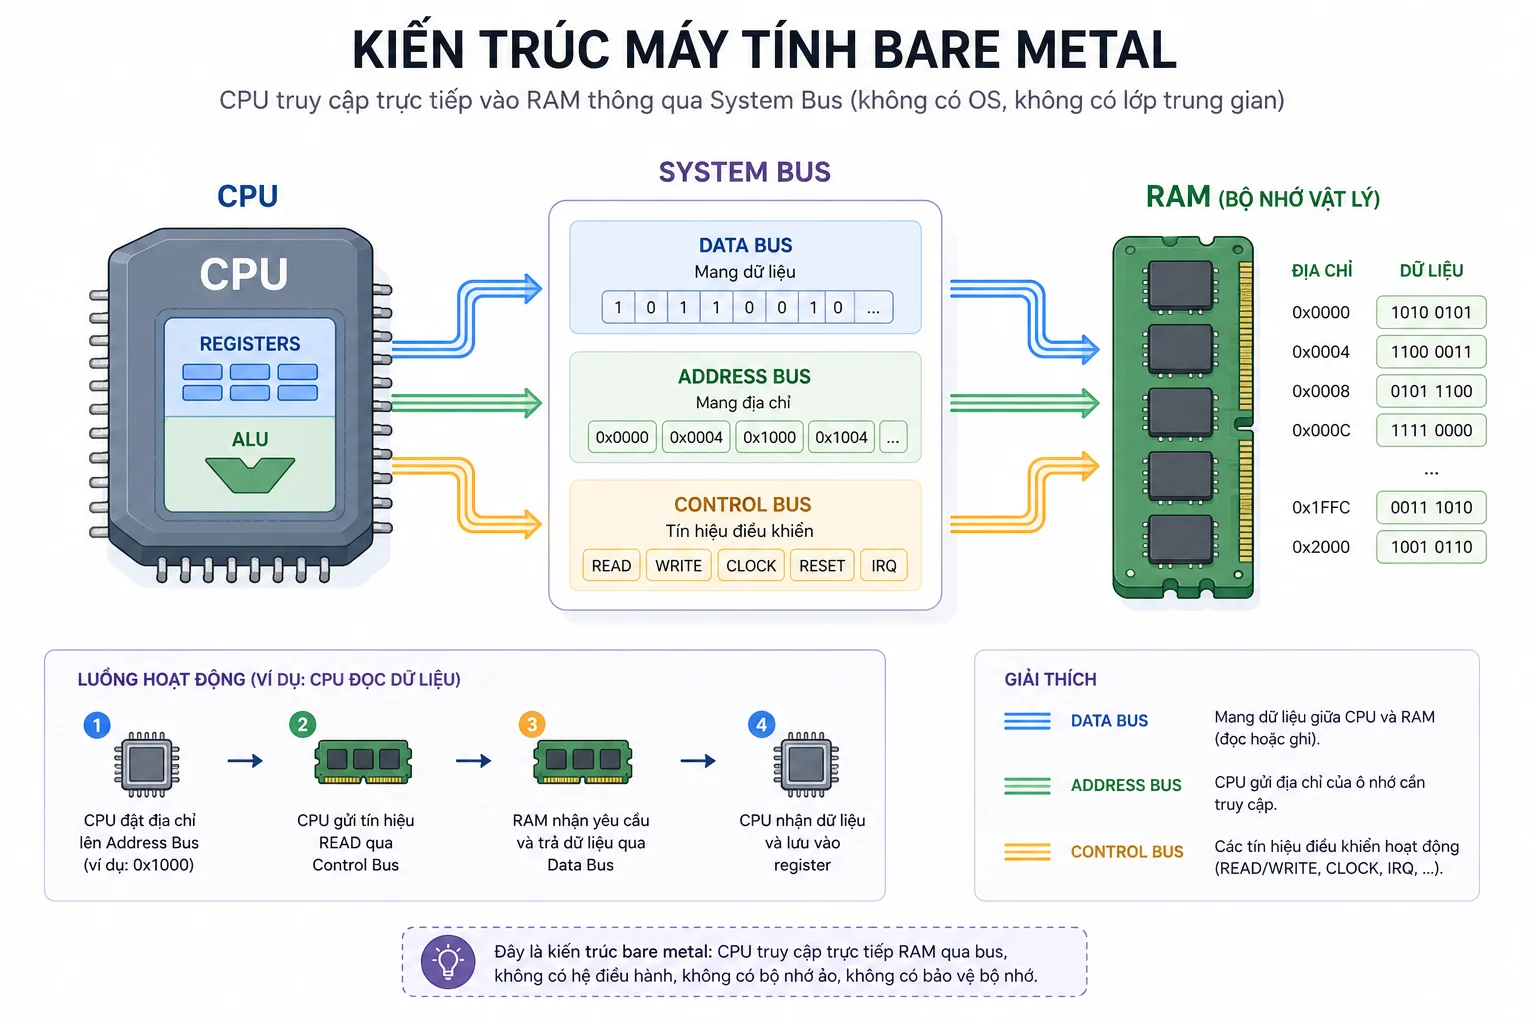
CPU không đọc text. Nó phản hồi với điện áp. Trình biên dịch dịch mã nguồn thành file nhị phân (machine code), nơi 1 và 0 đại diện cho mức điện áp cụ thể (ví dụ: 1 = 3.3V, 0 = 0V).
RAM là một mảng hàng tỷ tụ điện siêu nhỏ. Việc nạp chương trình vào bộ nhớ chính là quá trình bơm dòng điện để lật trạng thái các tụ điện này khớp với biểu đồ nhị phân của file thực thi. Code lúc này không còn là phần mềm—nó là trạng thái vật lý của phần cứng.
CPU là một cỗ máy trạng thái (State Machine)
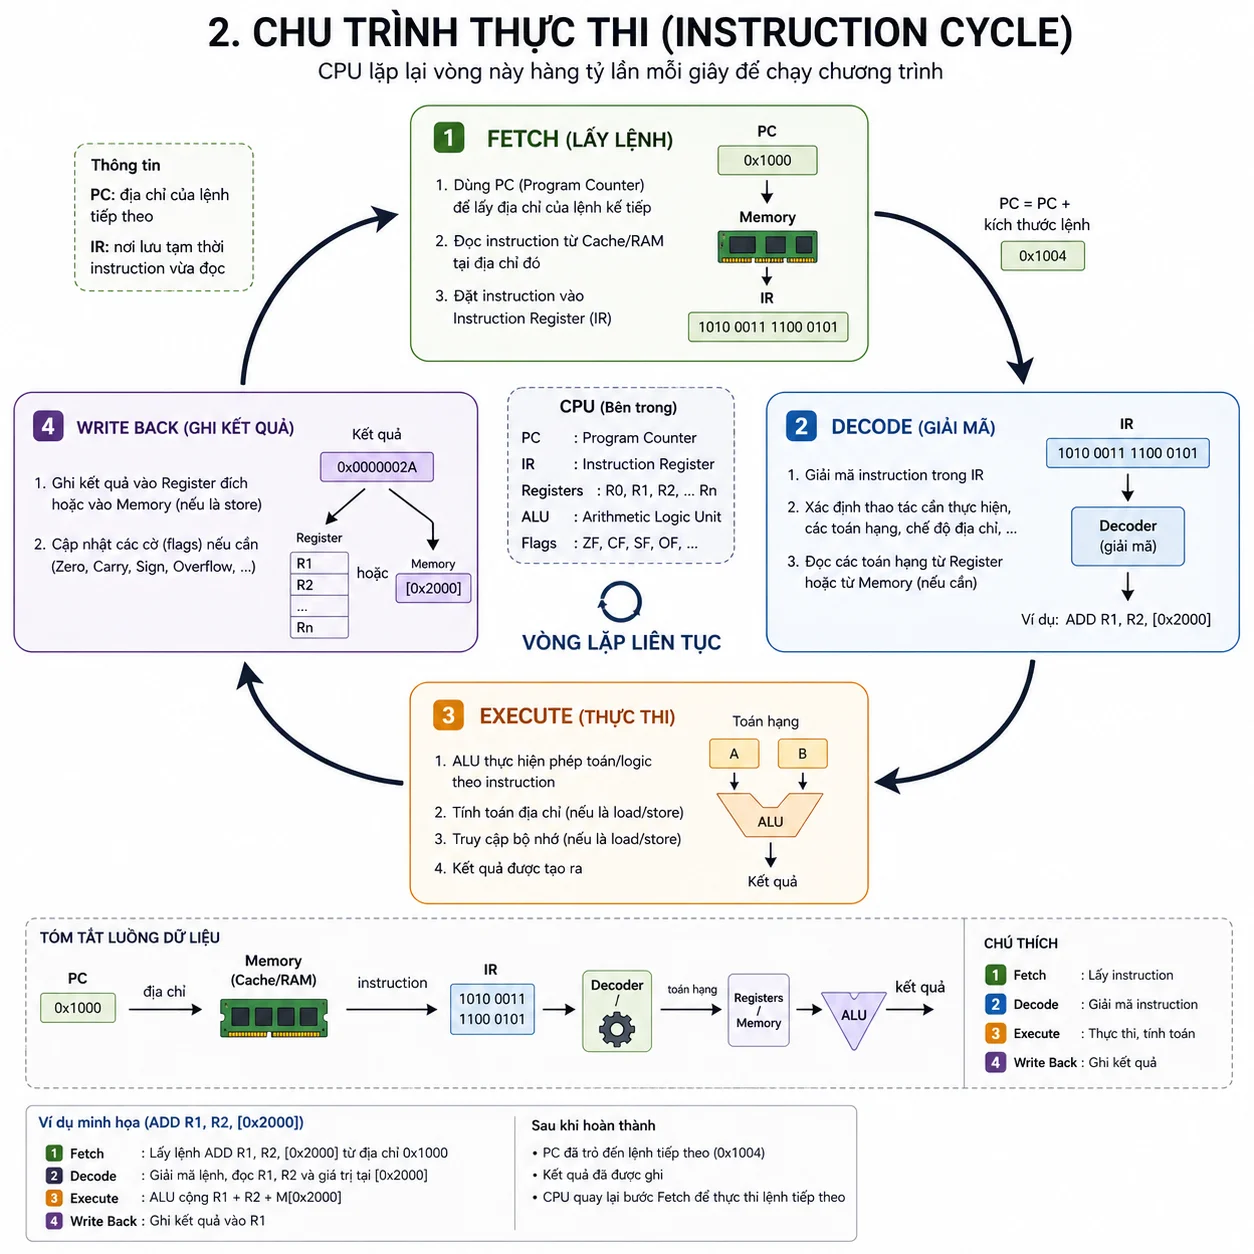
CPU là một mạch logic phức tạp kết nối với RAM qua Bus. Nó hoạt động dựa trên một chu trình cố định không thể phá vỡ: Fetch - Execute.
- Fetch: Bộ đếm chương trình (Program Counter - PC) giữ địa chỉ của lệnh tiếp theo. CPU truyền tín hiệu điện qua Bus đến địa chỉ đó trên RAM và đọc trạng thái điện áp trả về (ví dụ:
10110001). - Execute: Tín hiệu điện này chảy vào CPU, tự động định tuyến qua các cổng logic để kích hoạt một mạch vật lý cụ thể (ví dụ: ALU để thực hiện phép cộng).
Khi hoàn tất, PC tăng lên, và chu trình lặp lại hàng tỷ lần mỗi giây.
Quá trình thực thi vật lý của biến và hàm
Mô phỏng dưới đây minh họa quá trình ánh xạ trực tiếp từ C++ sang Assembly và trạng thái phần cứng:
CPU Simulator
Khởi động (Bare Metal): Mã nhị phân đã nằm sẵn trong bộ nhớ (Code Segment). CPU được cấp nguồn và trỏ tới lệnh đầu tiên.
print(a);
1. Khởi tạo giá trị (int a = 3)
CPU đọc lệnh MOV EAX, 3 từ thanh chỉ đường IP (Instruction Pointer). CPU liền nạp số 3 vào sổ nháp bên trong lõi của nó là thanh ghi EAX. Lúc này biến a ở ngoài RAM vẫn chưa hề tồn tại!
2. Phép tính (+ 5)
CPU đọc lệnh ADD EAX, 5. Bộ tính toán (ALU) lấy số 3 đang có sẵn trong EAX cộng thêm 5 thành 8. Kết quả 8 này lại được ghi đè ngược vào EAX. Mọi thứ vẫn chỉ diễn ra siêu nhanh trong lõi CPU.
3. Gán vào biến a (Lưu ra RAM)
Lúc này CPU mới dùng lệnh MOV [RAM], EAX để mang con số 8 từ sổ nháp EAX đem ra ngoài RAM. Vùng nhớ trên RAM dành cho biến a chính thức được cập nhật giá trị 8. Biến a ra đời.
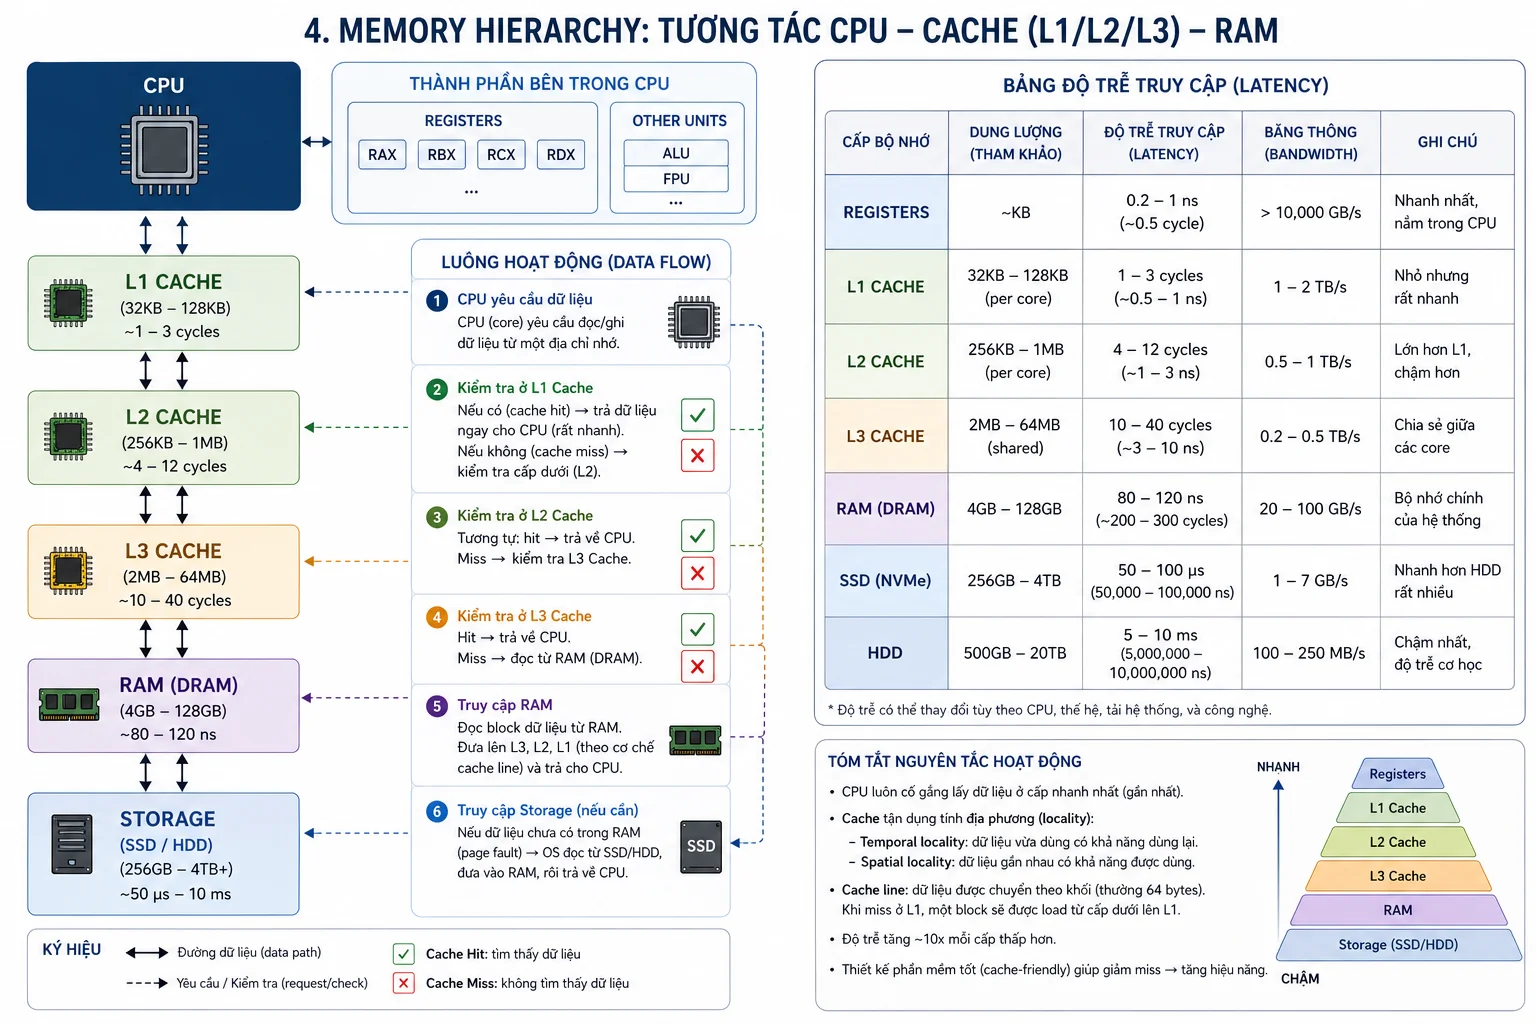
Lưu ý: Việc ghi ra RAM tốn rất nhiều thời gian. CPU thường “lười” và cố gắng cộng dồn trong EAX cho xong rồi mới ghi ra RAM một thể (đây chính là công dụng của thanh ghi và bộ nhớ Cache). Đó là lý do trong lập trình IoT/C++, đôi khi ta phải dùng từ khóa
volatileđể ép CPU: “Lần nào cộng cũng phải phóng điện ra tận RAM gốc để cập nhật!”.
4. Cơ chế nhảy hàm (print(a))
Khi gặp lệnh gọi hàm (CALL print), CPU phải nhảy tới một địa chỉ khác trên RAM để chạy code của hàm print. Nhưng nhảy đi xong thì làm sao biết đường quay về luồng chính? Đó là lúc vùng nhớ Ngăn xếp (Stack) ra tay. CPU sẽ cất địa chỉ quay về vào Stack như kiểu rải bánh mì đánh dấu đường. Chạy xong hàm print, CPU lôi địa chỉ từ Stack ra và quay lại đúng nơi nó đã rời đi.
Chi phí Abstraction: Đánh đổi RAM lấy Latency
Lưu trữ số 1 chỉ cần 1 bit. Vậy tại sao kiểu int mặc định trong C++ chiếm 32 bit (4 bytes)? Đây là một sự đánh đổi có chủ ý để tối ưu hóa latency ở cấp độ vi kiến trúc:
- Memory Alignment: Một CPU 32-bit có bus dữ liệu rộng 32 bit. Nó đọc một khối (word) 32-bit trong một chu kỳ xung nhịp. Việc cấp phát chính xác 32 bit cho một biến cho phép CPU lấy dữ liệu trong một thao tác duy nhất. Cố gắng tiết kiệm RAM bằng cách dùng 8-bit (
uint8_t) có thể buộc CPU phải dùng thêm các cổng logic masking để trích xuất byte cần thiết, gây tăng độ trễ vi mô. - Deterministic Memory Footprint: Khi
int a = 1;được cấp phát 32 bit, hệ thống đảm bảo vị trí bộ nhớ này sẽ không thay đổi ngay cả khi giá trị tăng lên2.000.000.000. Không cần cấp phát lại vùng nhớ (reallocation), loại bỏ chi phí overhead trong runtime.
C/C++ cho phép lập trình viên kiểm soát chính xác footprint này dựa trên ràng buộc của phần cứng (uint8_t vs int32_t). Ngược lại, CPython 64-bit sử dụng 28 bytes cho lệnh a = 1 vì nó phải đính kèm metadata động của đối tượng. Mức độ trừu tượng cao hơn luôn đi kèm với chi phí (abstraction penalty) về cả RAM và CPU cycles.
[!TIP] Góc Nerd: Vật lý Bán dẫn của RAM và CPU
Dù cùng chế tạo từ silicon, kiến trúc bán dẫn của RAM và bộ nhớ CPU khác biệt hoàn toàn, định hình hiệu năng của hệ thống:
- DRAM (Bộ nhớ chính): Tối ưu hóa cho mật độ (Density). Mỗi bit được lưu trữ bằng 1 Transistor và 1 Tụ điện (1T1C). Thiết kế này rẻ và dung lượng cao, nhưng tụ điện rò rỉ điện tích liên tục, đòi hỏi chu kỳ refresh hàng nghìn lần mỗi giây. Việc xả dòng điện vi phân và khuếch đại qua Sense Amplifier khiến độ trễ truy cập RAM vật lý cực kỳ cao.
- SRAM (Cache/Registers trong CPU): Tối ưu hóa cho tốc độ. Sử dụng mạch Flip-Flop (4-6 Transistor) để lưu trữ tĩnh mà không cần tụ điện hay refresh cycle. Tốc độ đọc/ghi diễn ra tức thời theo xung nhịp CPU, nhưng kiến trúc này chiếm diện tích silicon lớn, tản nhiệt nhiều và chi phí sản xuất cực kỳ đắt đỏ.
Sự thật về Code, Data, Heap và Stack trên Bare Metal
Chúng ta thường nghe về 4 vùng nhớ cốt lõi: Code, Data, Heap, và Stack. Trong một môi trường có Hệ điều hành (OS), các vùng này được ảo hóa liền mạch và bảo vệ nghiêm ngặt. Nhưng trên Bare Metal, nơi không có OS, liệu chúng có tồn tại?
Câu trả lời là Có, nhưng dưới một dạng thức thô sơ và nguy hiểm hơn nhiều:
- Code (Text): Mã máy thường được nạp cứng vào bộ nhớ Flash (ROM) thay vì RAM để tiết kiệm không gian. CPU sẽ đọc và thực thi trực tiếp từ Flash.
- Data & BSS: Khi chip vừa được cấp điện, một đoạn “Startup Code” tí hon sẽ âm thầm copy các giá trị khởi tạo từ Flash thả vào những địa chỉ đầu tiên của RAM vật lý để tạo ra vùng Data chứa các biến toàn cục.
- Heap & Stack: Trình liên kết (Linker Script) sẽ đóng vai trò “phân lô bán nền” trên phần RAM vật lý còn lại. Nó cắm mốc ở điểm cuối cùng của thanh RAM và cho Stack mọc ngược xuống, phần ở giữa sẽ dành cho Heap mọc lên.
Sự khác biệt chí mạng: Không có OS nghĩa là không có cơ chế bảo vệ bộ nhớ (Memory Protection). Nếu bạn cấp phát Heap quá mức hoặc gọi đệ quy khiến Stack mọc quá dài, chúng sẽ đâm sầm vào nhau trên RAM vật lý. Sự va chạm này sẽ ghi đè trực tiếp dữ liệu phần cứng, khiến vi điều khiển chạy sai logic một cách ma quái hoặc chết cứng (HardFault) mà không để lại bất kỳ một dòng cảnh báo nào.
Hệ điều hành (OS) làm trung gian
Bare metal cung cấp quyền kiểm soát trực tiếp phần cứng, nhưng không khả thi cho môi trường đa nhiệm. Một General Purpose OS (Windows, Linux, macOS) trừu tượng hóa phần cứng, tước bỏ quyền kiểm soát trực tiếp của ứng dụng bằng cách giới thiệu khái niệm Tiến trình (Process).
Sự ra đời của Tiến trình (Program vs Process)
Trong Bare Metal, khái niệm Tiến trình không tồn tại. CPU chỉ cắm đầu chạy một luồng lệnh duy nhất từ lúc cấp điện. Khi có OS, chúng ta cần phân biệt hai khái niệm cốt lõi:
- Program (Chương trình): Giống như một tờ công thức nấu ăn (ví dụ file
.exe,ELF). Nó chỉ là tập hợp các byte tĩnh nằm im lìm trên ổ cứng, không tiêu tốn RAM hay CPU. - Process (Tiến trình): Là khi bạn mang tờ công thức đó vào bếp để nấu. Nó là một thực thể sống động đang chạy, chiếm dụng bộ nhớ RAM, CPU và có trạng thái riêng.
Khi bạn click đúp vào một phần mềm, OS làm công việc của một người dàn dựng:
- Dọn dẹp sân khấu: OS khoanh vùng một khu vực RAM trống và chia thành 4 mảng: Code (copy mã máy từ ổ cứng dán vào), Data (chứa biến toàn cục), Heap (để cấp phát động), và Stack (ngăn xếp cục bộ).
- Làm giấy tờ tùy thân (PCB): OS tạo ra một khối dữ liệu gọi là Process Control Block (PCB) chứa thẻ định danh (PID), trạng thái chạy, và không gian để lưu trữ các thanh ghi CPU.
- Trao chìa khóa cho CPU: Khác với Bare Metal nơi con trỏ lệnh (
EIP) trỏ vào địa chỉ vật lý cứng, OS sẽ ép thanh ghiEIPtrỏ thẳng vào dòng code đầu tiên (hàmmain()) của không gian RAM vừa cấp. Lúc này, CPU mới bắt đầu chu trình Fetch-Execute.
Bằng cách này, OS tạo ra ảo giác rằng mỗi Process sở hữu trọn vẹn một cái CPU và một thanh RAM khổng lồ. Vậy làm sao OS ngăn các Process phá phách dữ liệu của nhau?
Bộ nhớ ảo (Virtual Memory) và MMU
Trong chế độ Bare Metal, một con trỏ giữ địa chỉ vật lý tuyệt đối. Trên một OS đa năng, thao tác truy cập trực tiếp bị phần cứng cấm.
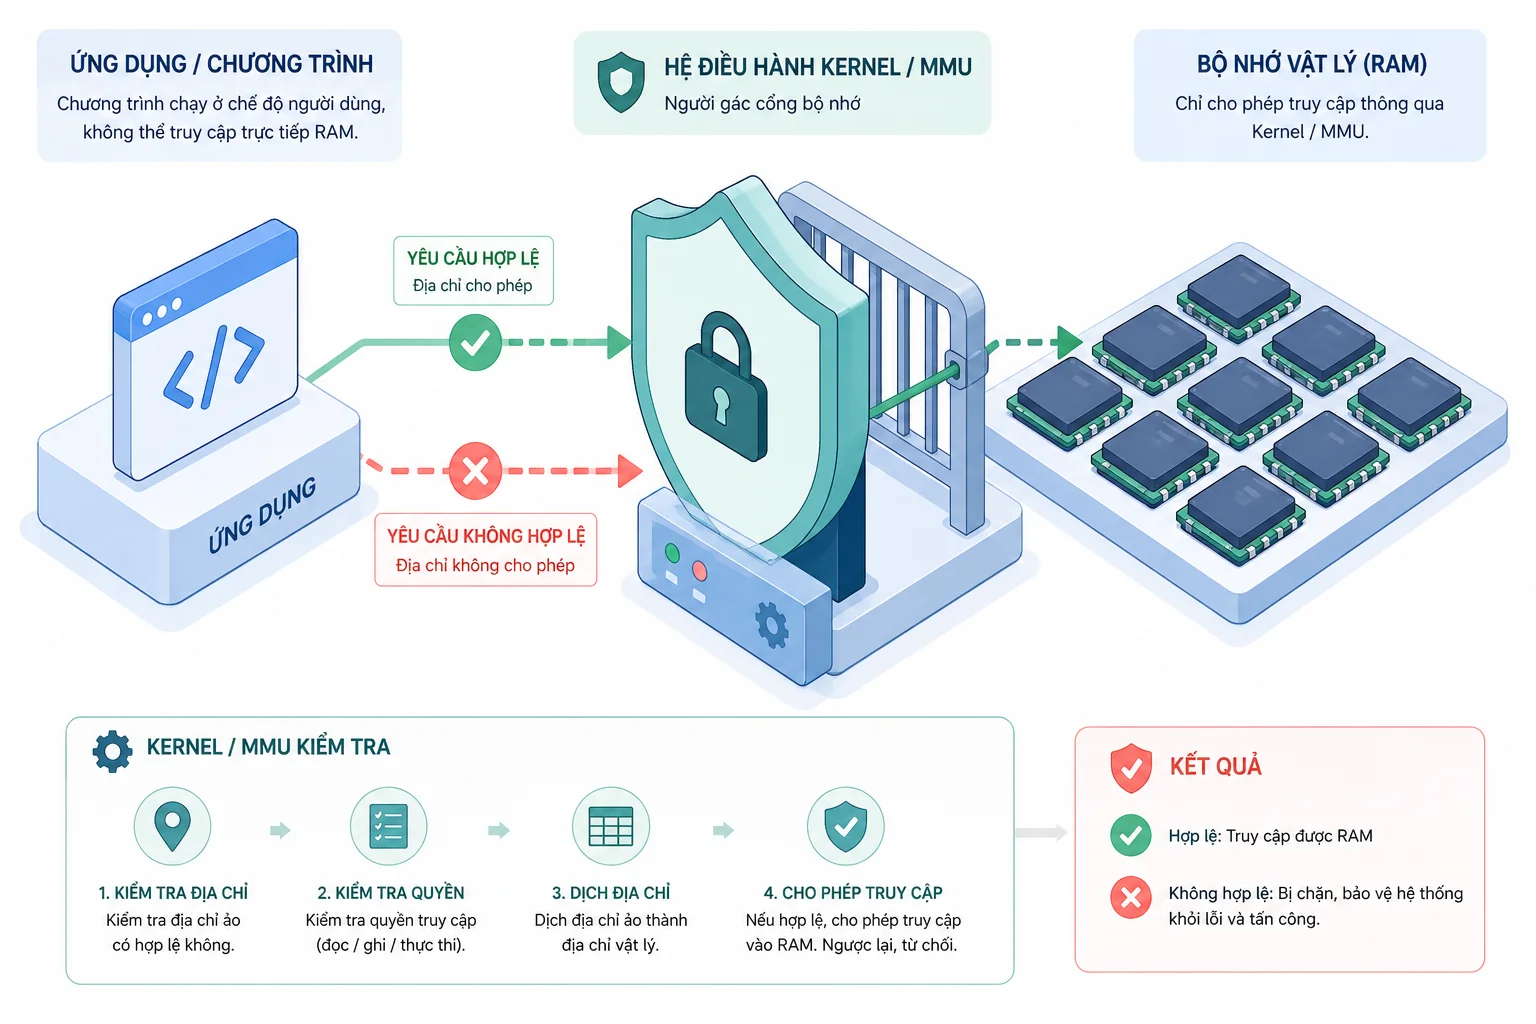
OS phối hợp với Memory Management Unit (MMU) để cấp cho mỗi tiến trình một không gian địa chỉ ảo (Virtual Memory). Tiến trình hoạt động như thể nó sở hữu bộ nhớ liên tục. Thực tế, MMU tự động ánh xạ (map) các địa chỉ ảo này vào các physical frames phân mảnh trên RAM thông qua các Page Tables.
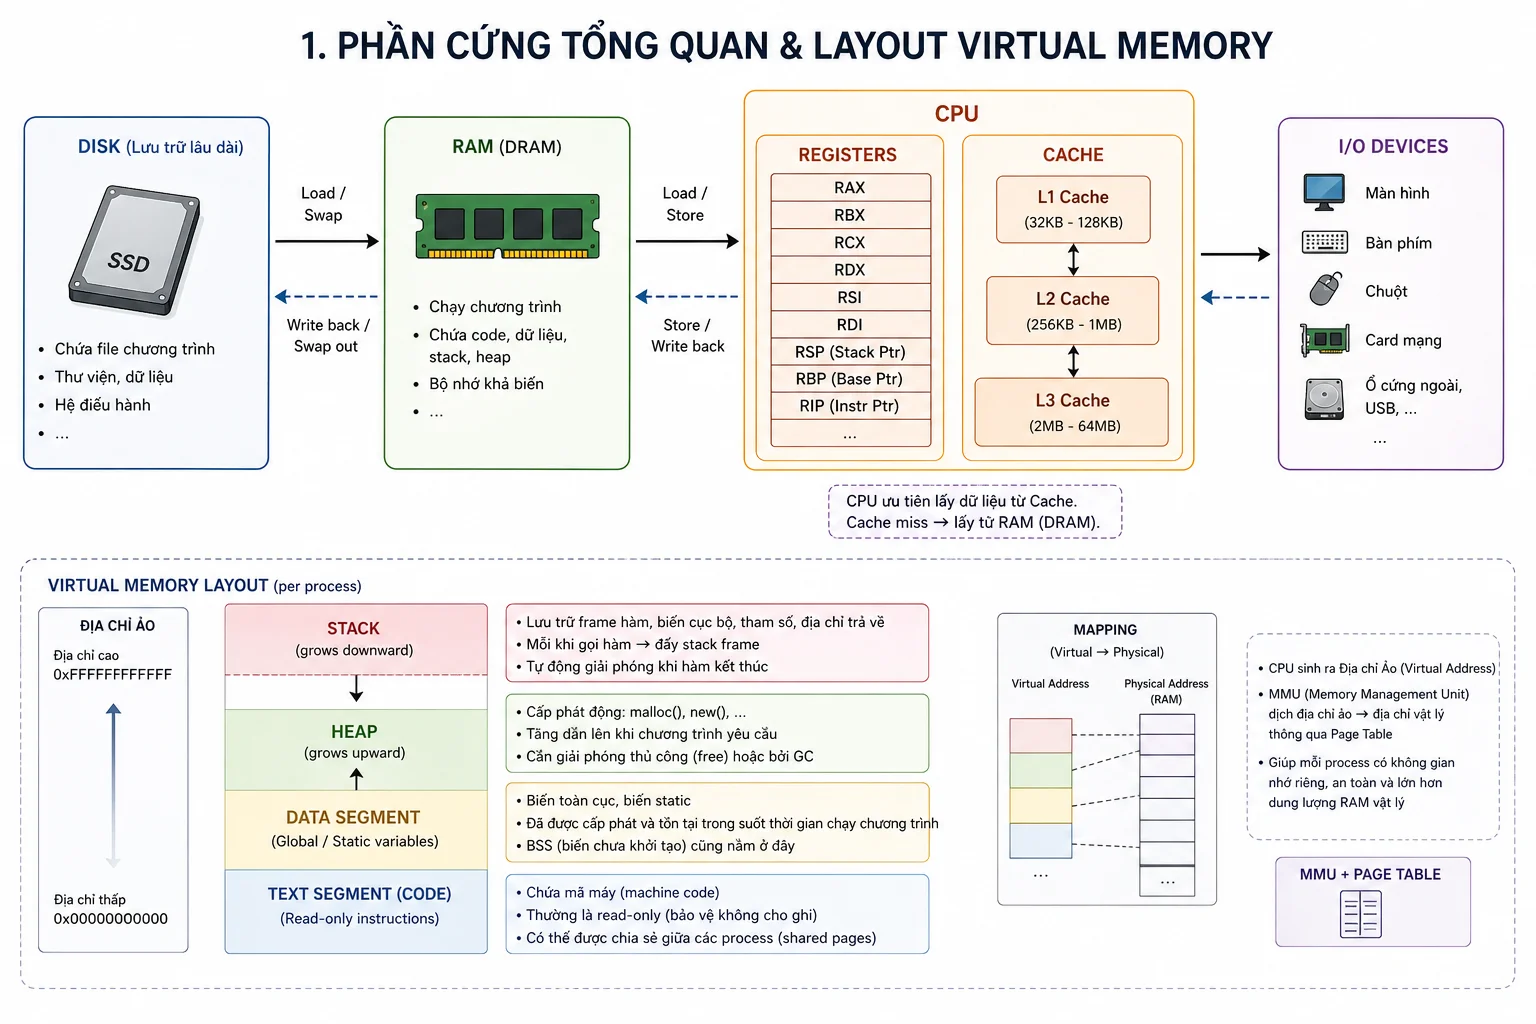
Bất kỳ nỗ lực nào nhằm truy cập vào bộ nhớ chưa được ánh xạ hoặc thuộc về tiến trình khác đều tạo ra lỗi phần cứng (Page Fault), khiến OS chấm dứt tiến trình (Segmentation fault).
Ví dụ: Segmentation Fault Đoạn code sau mô phỏng việc truy cập vùng nhớ trái phép trên OS:
int* ptr = (int*)0x12345678;
*ptr = 100;- Tiến trình (Process) yêu cầu ghi giá trị
100vào địa chỉ ảo0x12345678. - MMU tra cứu trong Page Table và phát hiện địa chỉ này chưa được ánh xạ hợp lệ (hoặc thuộc về Kernel/Tiến trình khác).
- Phần cứng kích hoạt một exception gửi đến OS Kernel. OS lập tức kill tiến trình với lỗi
SIGSEGV(Segmentation fault).
Phân quyền thông qua System Calls
User processes thi hành ở mức đặc quyền thấp (User Mode, Ring 3 trên x86). Chúng không thể giao tiếp trực tiếp với I/O (disk, network, display). Bất kỳ thao tác I/O nào cũng yêu cầu System Call (Syscall).
Ví dụ lệnh in std::cout << "Hello World!";:
- Tiến trình gọi thư viện chuẩn, kích hoạt một instruction đặc quyền (như
syscalltrên x86_64). - CPU thực hiện một Context Switch, nâng đặc quyền lên Kernel Mode (Ring 0) và nhảy đến hàm xử lý của Kernel.
- Kernel kiểm tra quyền hạn, thực thi I/O request, sau đó hạ đặc quyền và trả luồng thực thi về User Mode.
Chu trình chuyển đổi User/Kernel mode này tốn kém cycles. Các ứng dụng tối ưu hiệu năng cao (database, high-frequency trading) phải sử dụng kiến trúc như io_uring hoặc I/O batching để giảm thiểu tần suất gọi Syscall.
CPU Scheduling và Context Switching
Một CPU core vật lý chỉ chạy một luồng tại một thời điểm. OS tạo ảo giác về tính đa nhiệm thông qua time-slicing.
Scheduler của OS phân bổ CPU time cho các tiến trình:
- Tiến trình A thi hành trong giới hạn time quantum (ví dụ: 10ms).
- Timer interrupt kích hoạt. Kernel đình chỉ Tiến trình A, lưu trạng thái Register và PC của nó vào Process Control Block (PCB).
- Kernel khôi phục trạng thái của Tiến trình B và chuyển luồng thực thi cho B.
Đây là một quá trình Context Switch. Nó có chi phí tốn kém do phải lưu/đọc trạng thái register và làm mất hiệu lực (invalidate) CPU Cache và TLB, gây sụt giảm hiệu năng.
Context Switch Simulator
Chạy Tiến trình A (Chrome): CPU đang thực thi code của Chrome. EIP trỏ vào không gian RAM của Chrome.
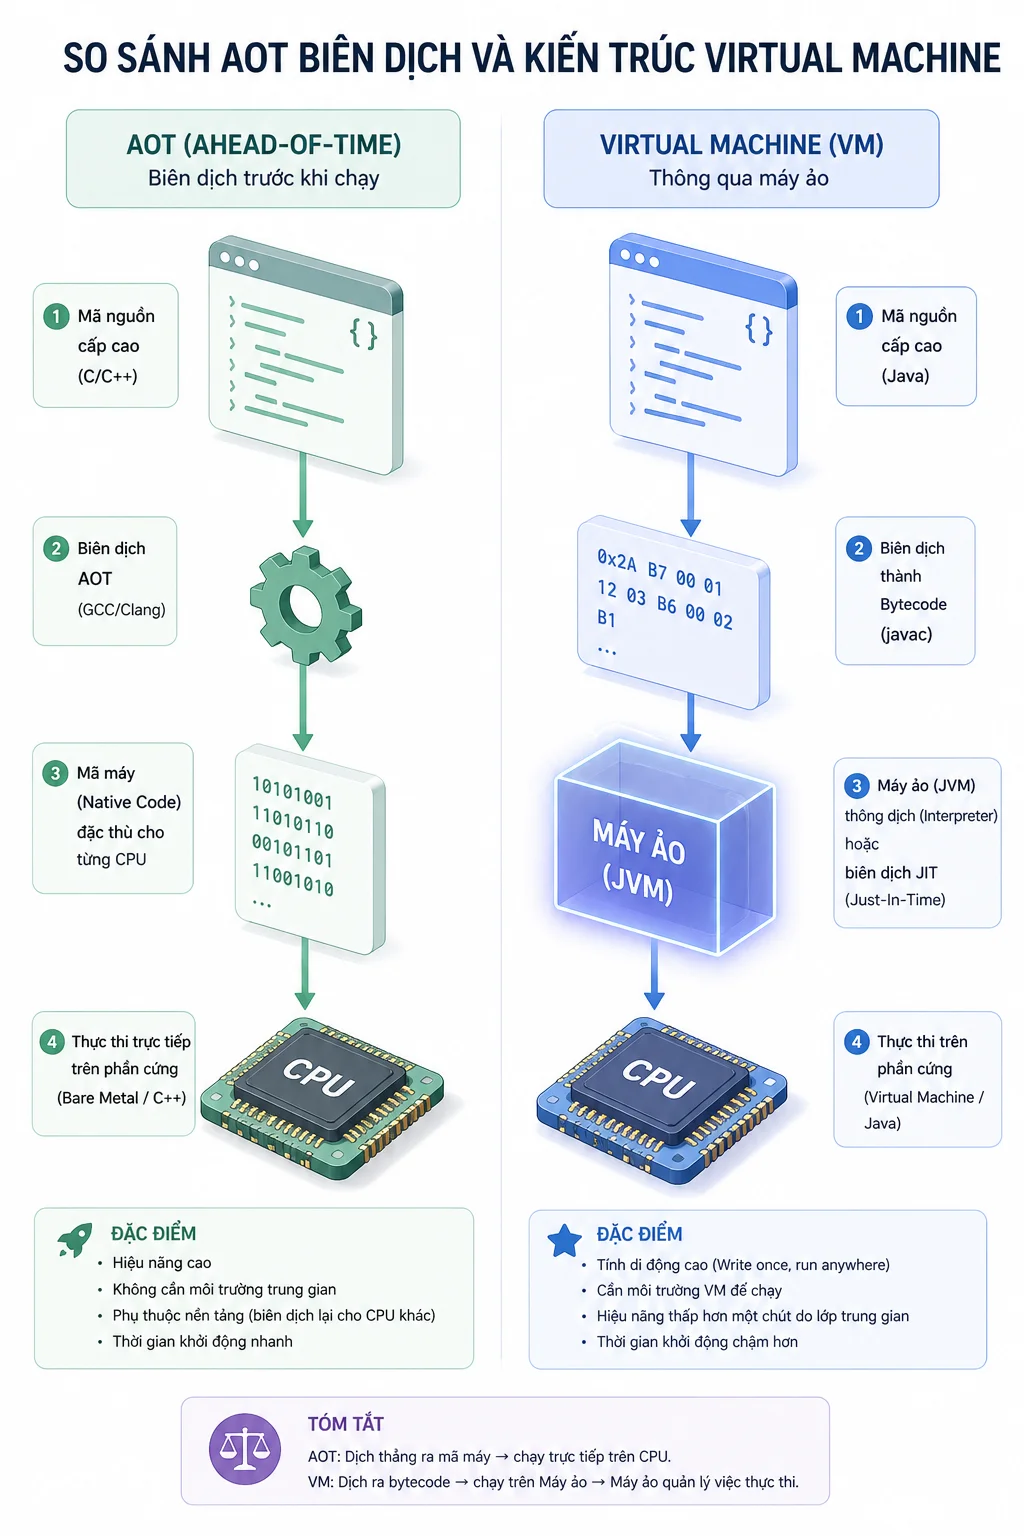
[!NOTE] Mặc dù được quản lý bởi OS, C/C++ vẫn được biên dịch Ahead-of-Time (AOT) ra mã máy nguyên bản. Binary được biên dịch cho Windows x86 sẽ không chạy được trên macOS ARM. Cross-platform execution yêu cầu một mô hình trừu tượng cao hơn: Máy ảo (VM).
Thực thi trên Virtual Machine (Java, Node.js, Python)
Các ngôn ngữ như Java, C#, JavaScript và Python đánh đổi quyền kiểm soát native để lấy sự linh hoạt trên mọi nền tảng (Write Once, Run Anywhere).
Kiến trúc VM và Bytecode
Source code không được biên dịch ra mã máy native, mà được chuyển đổi thành Bytecode—một Instruction Set trung gian. Các instruction này không được thực thi trực tiếp bởi phần cứng, mà bởi một process native của OS gọi là Máy ảo (JVM, V8, CLR).
VM chuyển đổi Bytecode thành thao tác phần cứng thông qua hai cơ chế chính:
- Interpreter (Thông dịch): Đọc, giải mã và thực thi từng lệnh Bytecode tuần tự. Thao tác này chậm vì chu kỳ fetch-decode do phần mềm mô phỏng có chi phí overhead khổng lồ so với phần cứng.
- Just-In-Time (JIT) Compilation: VM định tuyến quá trình thực thi và thu thập telemetry. Các đoạn code được thực thi tần suất cao (Hot paths) sẽ được JIT compiler biên dịch on-the-fly thành mã máy native và lưu vào RAM. Các lần thực thi tiếp theo sẽ chạy thẳng mã native này mà không cần thông qua bước thông dịch.
JIT Compilation Pipeline (V8 Engine)
Thực thi vòng lặp JavaScript bằng engine V8:
function add(a, b) {
  return a + b;
}
for (let i = 0; i < 10000; i++) {
  add(i, 1);
}- Interpretation: V8 biên dịch
addthành bytecode. Trình thông dịch thực thi trực tiếp các vòng lặp đầu tiên, xử lý chậm do quá trình type check linh động. - JIT Compilation (TurboFan): Khi hàm được gọi đủ số lần, V8 phân tích (profile) hàm và phán đoán: “Các biến này luôn là số nguyên (integers)”. Nó biên dịch hàm
addthành mã máy native tối ưu nghiêm ngặt cho integer. - De-optimization: Tại vòng lặp 10001, nếu bạn truyền vào một string
add("Hello", 1), phán đoán trước đó bị sai. V8 hủy (invalidate) đoạn mã native đã biên dịch, buộc tiến trình phải de-optimize và trở lại execution pipeline của trình thông dịch.
V8 JIT Compiler Simulator
Interpreter (Thông dịch): V8 Engine đọc và dịch từng dòng code JavaScript sang Bytecode. Tốc độ thực thi rất chậm vì liên tục phải kiểm tra kiểu dữ liệu (Type Checking).
Kiến trúc Managed Runtime mang lại lợi thế về memory safety (Garbage Collection) và tính di động, nhưng sinh ra abstraction overhead đáng kể: chi phí CPU runtime để quản lý JIT, tiêu thụ RAM từ footprint của VM host, và độ trễ do Cold Start.
Tổng Kết Kiến Trúc
- Bare Metal (C/C++/Rust): Thi hành phần cứng nguyên thủy. Machine code chi phối trực tiếp cổng logic CPU và thanh RAM. Hiệu năng tối đa, không rào cản.
- OS-Managed (C/C++/Rust trên OS): Abstraction level 1. Process bị cô lập bởi MMU qua Virtual Memory. Thao tác I/O bị block cứng và phụ thuộc hoàn toàn vào context switch thông qua Syscalls.
- Virtual Machine (Java/Node/Python): Abstraction level 2. Logic được gói trong Bytecode, vận hành bên trong process của Host VM. Đánh đổi overhead của Interpreter/JIT, Garbage Collector và Memory Layout mờ đục để đổi lấy an toàn tĩnh và sự tiện lợi.
Kỹ nghệ phần mềm là bộ môn nghệ thuật quản lý “abstraction penalty”. Việc lựa chọn cấp độ trừu tượng không quyết định trình độ kỹ sư, nhưng hiểu rõ cơ chế vận hành của lớp vật lý bên dưới là yêu cầu tiên quyết để tối ưu hóa hiệu năng của bất kỳ hệ thống nào.